代码重构技巧
文章摘要:项目在不断演进过程中,代码不停地在堆砌。如果没有人为代码的质量负责,代码总是会往越来越混乱的方向演进。当混乱到一定程度之后,量变引起质变,项目的维护成本已经高过重新开发一套新代码的成本,想要再去重构,已经没有人能做到了。
关于重构
1.为什么要重构
项目在不断演进过程中,代码不停地在堆砌。如果没有人为代码的质量负责,代码总是会往越来越混乱的方向演进。当混乱到一定程度之后,量变引起质变,项目的维护成本已经高过重新开发一套新代码的成本,想要再去重构,已经没有人能做到了。
造成这样的原因往往有以下几点:
编码之前缺乏有效的设计
成本上的考虑,在原功能堆砌式编程
缺乏有效代码质量监督机制
对于此类问题,业界已有有很好的解决思路:通过持续不断的重构将代码中的“坏味道”清除掉。
2.什么是重构
重构一书的作者Martin Fowler对重构的定义:
重构(名词):对软件内部结构的一种调整,目的是在不改变软件可观察行为的前提下,提高其可理解性,降低其修改成本。
重构(动词):使用一系列重构手法,在不改变软件可观察行为的前提下,调整其结构。
根据重构的规模可以大致分为大型重构和小型重构:
大型重构 :对顶层代码设计的重构,包括:系统、模块、代码结构、类与类之间的关系等的重构,重构的手段有:分层、模块化、解耦、抽象可复用组件等等。这类重构的工具就是我们学习过的那些设计思想、原则和模式。这类重构涉及的代码改动会比较多,影响面会比较大,所以难度也较大,耗时会比较长,引入bug的风险也会相对比较大。
小型重构:对代码细节的重构,主要是针对类、函数、变量等代码级别的重构,比如规范命名和注释、消除超大类或函数、提取重复代码等等。小型重构更多的是使用统一的编码规范。这类重构要修改的地方比较集中,比较简单,可操作性较强,耗时会比较短,引入bug的风险相对来说也会比较小。
什么时候重构 :
新功能开发、修bug或者代码review中出现“代码坏味道”,我们就应该及时进行重构。持续在日常开发中进行小重构,能够降低重构和测试的成本。
代码的坏味道
代码重复:实现逻辑相同、执行流程相同
方法过长:
方法中的语句不在同一个抽象层级
逻辑难以理解,需要大量的注释
面向过程编程而非面向对象
过大的类
- 类做了太多的事情
- 包含过多的实例变量和方法
- 类的命名不足以描述所做的事情
逻辑分散
- 发散式变化:某个类经常因为不同的原因在不同的方向上发生变化
- 散弹式修改:发生某种变化时,需要在多个类中做修改
严重的情结依恋:某个类的方法过多的使用其他类的成员
数据泥团/基本类型偏执
两个类、方法签名中包含相同的字段或参数
应该使用类但使用基本类型,比如表示数值与币种的Money类、起始值与结束值的Range类
不合理的继承体系
继承打破了封装性,子类依赖其父类中特定功能的实现细节
- 子类必须跟着其父类的更新而演变,除非父类是专门为了扩展而设计,并且有很好的文档说明
过多的条件判断
过长的参数列
临时变量过多
令人迷惑的暂时字段:某个实例变量仅为某种特定情况而设置,将实例变量与相应的方法提取到新的类中
纯数据类:仅包含字段和访问(读写)这些字段的方法,此类被称为数据容器,应保持最小可变性
不恰当的命名
命名无法准确描述做的事情
- 命名不符合约定俗称的惯例
过多的注释或者过时的注释
1.坏代码的问题
难以复用:系统关联性过多,导致很难分离可重用部分
难于变化:一处变化导致其他很多部分的修改,不利于系统稳定
难于理解:命名杂乱,结构混乱,难于阅读和理解
难以测试:分支、依赖较多,难以覆盖全面
2.什么是好代码
代码质量的评价有很强的主观性,描述代码质量的词汇也有很多,比如可读性、可维护性、灵活、优雅、简洁。这些词汇是从不同的维度去评价代码质量的。其中,可维护性、可读性、可扩展性又是提到最多的、最重要的三个评价标准。
要写出高质量代码,我们就需要掌握一些更加细化、更加能落地的编程方法论,这就包含面向对象设计思想、设计原则、设计模式、编码规范、重构技巧等。
PS : 其实这里,个人感觉,更多情况下,还是会有很强的个人主观意识,比如 空格,table 之争,但是,核心还是是否按照各自的软件设计和编码规范即可,细节可能会带有浓重的个人主观意识色彩,大局还是仍需要按照规范进行
如何重构
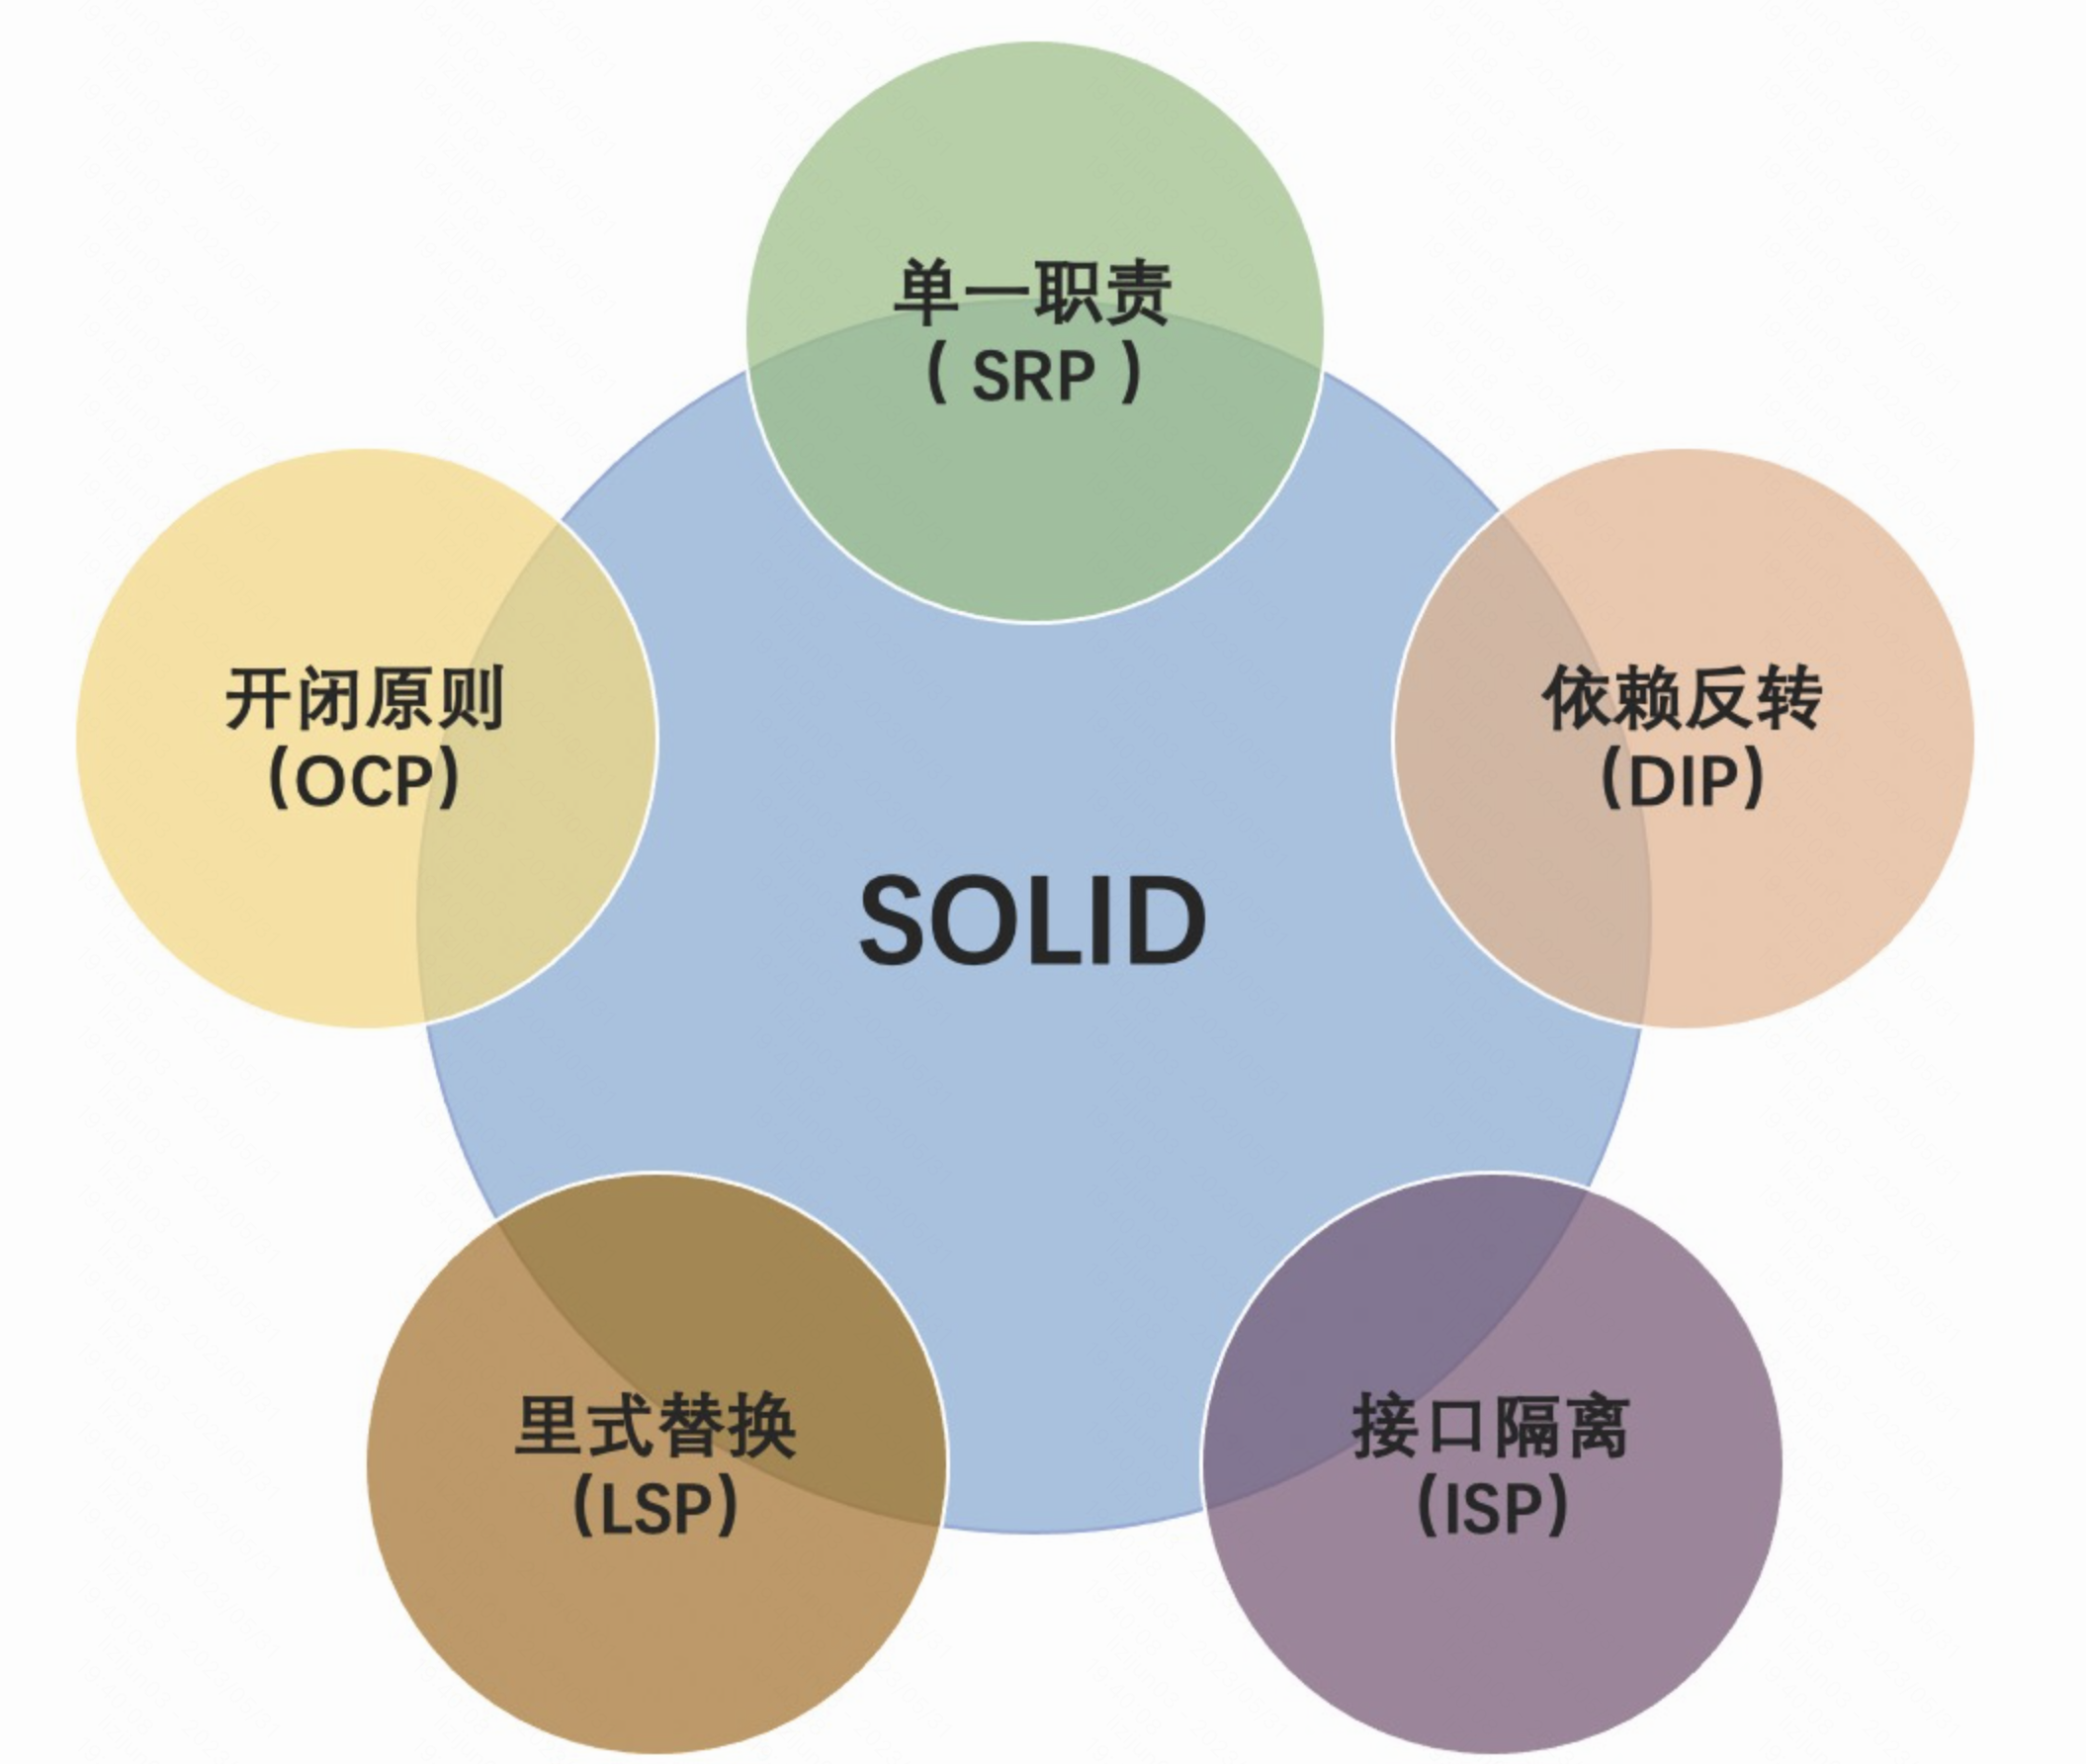
1.SOLID原则
2.设计模式
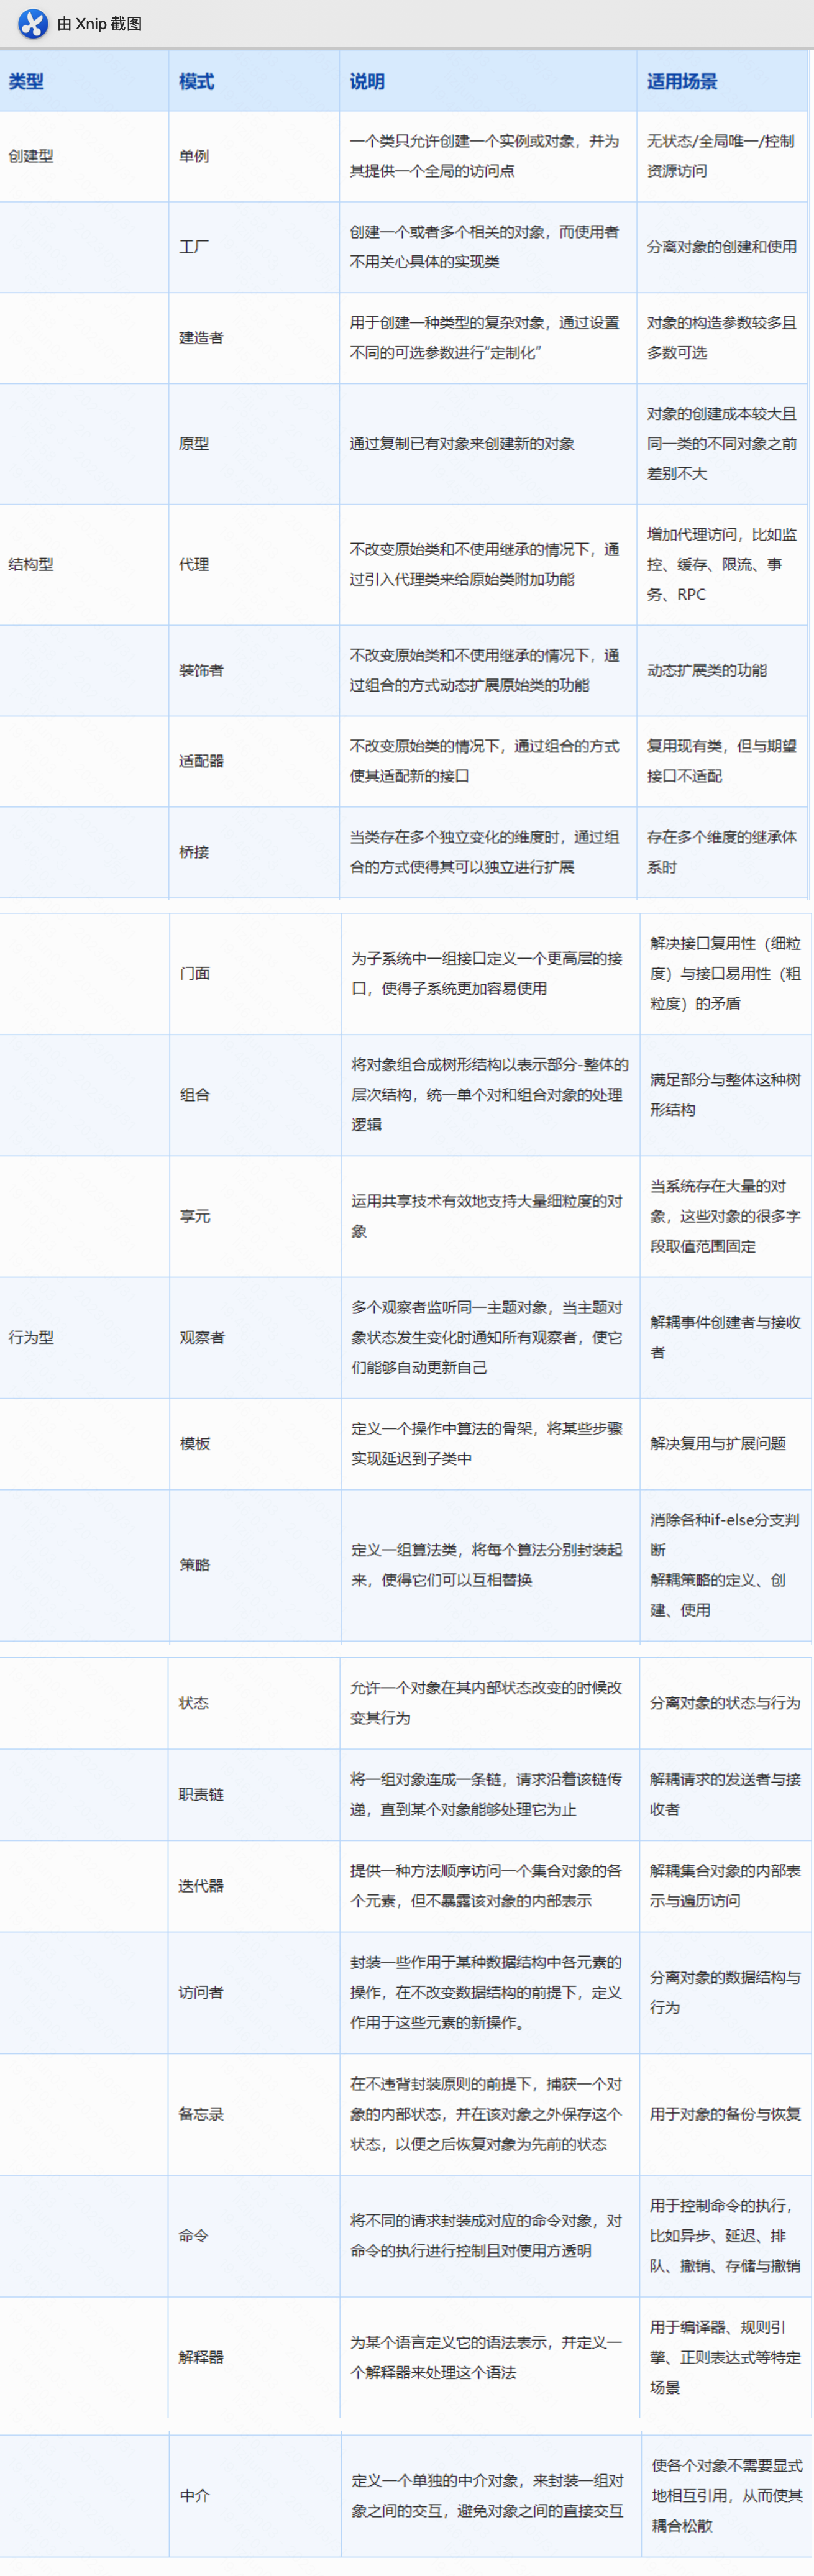
软件开发人员在软件开发过程中面临的一般问题的解决方案。
这些解决方案是众多软件开发人员经过相当长的一段时间的试验和错误总结出来的。
每种模式都描述了一个在我们周围不断重复发生的问题,以及该问题的核心解决方案。
3.代码分层
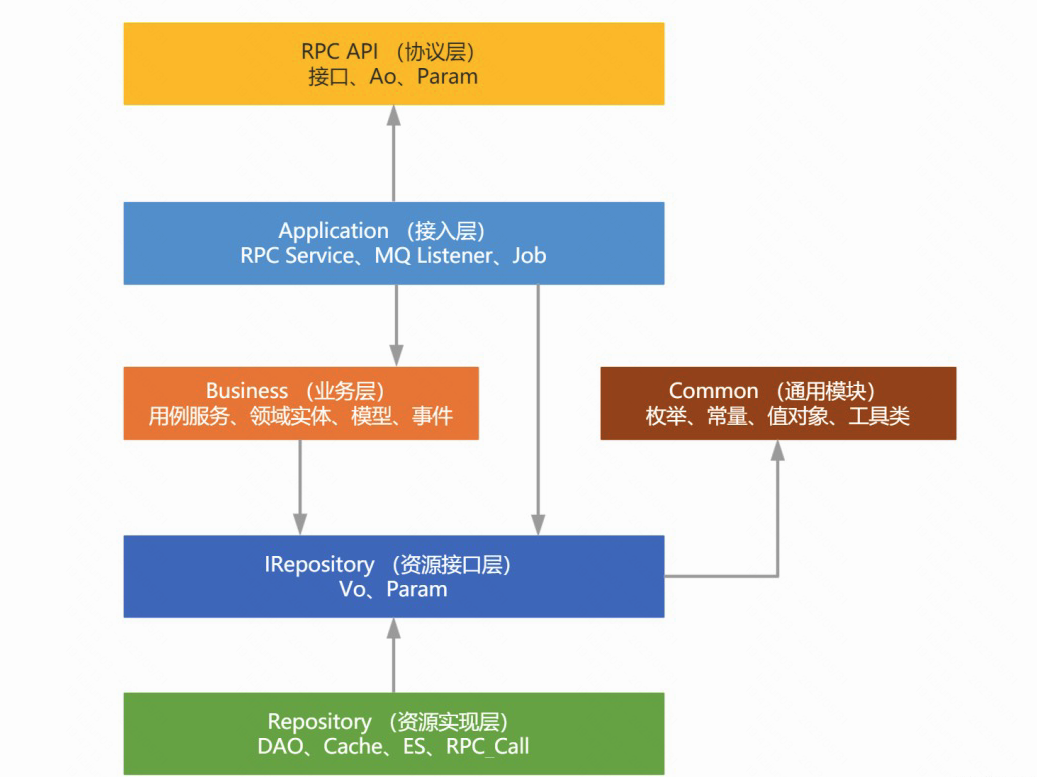
模块结构说明
server_main:配置层,负责整个项目的module管理,maven配置管理、资源管理等;
server_application:应用接入层,承接外部流量入口,例如:RPC接口实现、消息处理、定时任务等;不要在此包含业务逻辑;
server_biz:核心业务层,用例服务、领域实体、领域事件等
server_irepository:资源接口层,负责资源接口的暴露
server_repository:资源层,负责资源的proxy访问,统一外部资源访问,隔离变化。注意:这里强调的是弱业务性,强数据性;
server_common:公共层,vo、工具等
代码开发要遵守各层的规范,并注意层级之间的依赖关系。
4.命名规范
一个好的命名应该要满足以下两个条件:
准确描述所做得事情
格式符合通用的惯例
如果你觉得一个类或方法难以命名的时候,可能是其承载的功能太多了,需要进一步拆分。
重构的技巧
1.提炼方法
多个方法代码重复、方法中代码过长或者方法中的语句不在一个抽象层级。
方法是代码复用的最小粒度,方法过长不利于复用,可读性低,提炼方法往往是重构工作的第一步。
意图导向编程 :把处理某件事的流程和具体做事的实现方式分开。
把一个问题分解为一系列功能性步骤,并假定这些功能步骤已经实现
我们只需把把各个函数组织在一起即可解决这一问题
在组织好整个功能后,我们在分别实现各个方法函数
public class Transaction {
public Boolean commit(String command) {
    Boolean result = true;
    String[] tokens = tokenize(command);
    normalizeTokens(tokens);
    if (isALargeTransaction(tokens)) {
      result = processLargeTransaction(tokens);
    } else {
      result = processSmallTransaction(tokens);
    }
    return result;
}
}
2.以函数对象取代函数
将函数放进一个单独对象中,如此一来局部变量就变成了对象内的字段。
然后你可以在同一个对象中将这个大型函数分解为多个小型函数。
3.引入参数对象
方法参数比较多时,将参数封装为参数对象
4.移除对参数的绝对赋值
public int discount(int inputVal, int quantity, int yearToDate) {
  if (inputVal > 50) inputVal -= 2;
  if (quantity > 100) inputVal -= 1;
  if (yearToDate > 10000) inputVal -= 4;
  return inputVal;
}

public int discount(int inputVal, int quantity, int yearToDate) {
  int result = inputVal;
  if (inputVal > 50) result -= 2;
  if (quantity > 100) result -= 1;
  if (yearToDate > 10000) result -= 4;
  return result;
}
5.将查询与修改分离
任何有返回值的方法,都不应该有副作用
- 不要在convert中调用写操作,避免副作用
- 常见的例外:将查询结果缓存到本地
6.移除不必要临时变量
临时变量仅使用一次或者取值逻辑成本很低的情况下7.引入解释变量
将复杂表达式(或其中一部分)的结果放进一个临时变量,以此变量名称来解释表达式用途
if ((platform.toUpperCase().indexOf("MAC") > -1)
  && (browser.toUpperCase().indexOf("IE") > -1) && wasInitialized() && resize > 0) {
// do something
}


final boolean isMacOs = platform.toUpperCase().indexOf("MAC") > -1;
final boolean isIEBrowser = browser.toUpperCase().indexOf("IE") > -1;
final boolean wasResized = resize > 0;
if (isMacOs && isIEBrowser && wasInitialized() && wasResized) {
// do something
}
8.使用卫语句替代嵌套条件判断
把复杂的条件表达式拆分成多个条件表达式,减少嵌套。
嵌套了好几层的if - then-else语句,转换为多个if语句
//未使用卫语句
public void getHello(int type) {
  if (type == 1) {
      return;
  } else {
      if (type == 2) {
          return;
      } else {
          if (type == 3) {
              return;
          } else {
              setHello();
          }
      }
  }
}

//使用卫语句
public void getHello(int type) {
  if (type == 1) {
      return;
  }
  if (type == 2) {
      return;
  }
  if (type == 3) {
      return;
  }
  setHello();
}
9.使用多态替代条件判断
当出现大量类型检查和判断时,if else(或switch)语句的体积会比较臃肿,这无疑降低了代码的可读性。当存在这样一类条件表达式,它根据对象类型的不同选择不同的行为。可以将这种表达式的每个分支放进一个子类内的复写函数中,然后将原始函数声明为抽象函数。
另外,if else(或switch)本身就是一个“变化点”,当需要扩展新的类型时,我们不得不追加if else(或switch)语句块,以及相应的逻辑,这无疑降低了程序的可扩展性,也违反了面向对象的开闭原则。
基于这种场景,我们可以考虑使用“多态”来代替冗长的条件判断,将if else(或switch)中的“变化点”封装到子类中。这样,就不需要使用if else(或switch)语句了,取而代之的是子类多态的实例,从而使得提高代码的可读性和可扩展性。很多设计模式使用都是这种套路,比如策略模式、状态模式。
// 未使用多态
public int calculate(int a, int b, String operator) {
    int result = Integer.MIN_VALUE;
    if ("add".equals(operator)) {
        result = a + b;
    } else if ("multiply".equals(operator)) {
        result = a * b;
    } else if ("divide".equals(operator)) {
        result = a / b;
    } else if ("subtract".equals(operator)) {
        result = a - b;
    }
    return result;
}

// 使用多态
public interface Operation {
  int apply(int a, int b);
}
public class Addition implements Operation {
  @Override
  public int apply(int a, int b) {
    return a + b;
        }
}
public class OperatorFactory {
    private final static Map<String, Operation> operationMap = new HashMap<>();
    static {
        operationMap.put("add", new Addition());
        operationMap.put("divide", new Division());
        // more operators
    }
    public static Operation getOperation(String operator) {
        return operationMap.get(operator);
    }
}
public int calculate(int a, int b, String operator) {
    if (OperatorFactory .getOperation == null) {
       throw new IllegalArgumentException("Invalid Operator");
    }
    return OperatorFactory .getOperation(operator).apply(a, b);
}
10.使用异常替代返回错误
//使用错误码
public boolean withdraw(int amount) {
    if (balance < amount) {
        return false;
    } else {
        balance -= amount;
        return true;
    }
}

//使用异常
public void withdraw(int amount) {
    if (amount > balance) {
        throw new IllegalArgumentException("amount too large");
    }
    balance -= amount;
}
11.引入断言
某一段代码需要对程序状态做出某种假设,以断言明确表现这种假设。
不要滥用断言,不要使用它来检查“应该为真”的条件,只使用它来检查“一定必须为真”的条件
如果断言所指示的约束条件不能满足,代码是否仍能正常运行?如果可以就去掉断言
12.引入Null对象或特殊对象
当使用一个方法返回的对象时,而这个对象可能为空,这个时候需要对这个对象进行操作前,需要进行判空,否则就会报空指针。当这种判断频繁的出现在各处代码之中,就会影响代码的美观程度和可读性,甚至增加Bug的几率。
空引用的问题在Java中无法避免,但可以通过代码编程技巧(引入空对象)来改善这一问题
//空对象的例子
public class OperatorFactory {
  static Map<String, Operation> operationMap = new HashMap<>();
  static {
    operationMap.put("add", new Addition());
    operationMap.put("divide", new Division());
    // more operators
  }
  public static Optional<Operation> getOperation(String operator) {
    return Optional.ofNullable(operationMap.get(operator));
  }
}

  public int calculate(int a, int b, String operator) {
  Operation targetOperation = OperatorFactory.getOperation(operator)
     .orElseThrow(() -> new IllegalArgumentException("Invalid Operator"));
  return targetOperation.apply(a, b);
  }

  //特殊对象的例子
  public class InvalidOp implements Operation {
  @Override
  public int apply(int a, int b)  {
    throw new IllegalArgumentException("Invalid Operator");
  }
}
13.提炼类
//原始类
public class Person {
  private String name;
  private String officeAreaCode;
  private String officeNumber;

  public String getName() {
      return name;
  }
  public String getTelephoneNumber() {
      return ("(" + officeAreaCode + ")" + officeNumber);
  }
  public String getOfficeAreaCode() {
      return officeAreaCode;
  }
  public void setOfficeAreaCode(String arg) {
      officeAreaCode = arg;
  }
  public String getOfficeNumber() {
      return officeNumber;
  }
  public void setOfficeNumber(String arg) {
      officeNumber = arg;
  }
}
//新提炼的类(以对象替换数据值)
public class TelephoneNumber {
  private String areaCode;
  private String number;

  public String getTelephnoeNumber() {
      return ("(" + getAreaCode() + ")" + number);
  }
  String getAreaCode() {
      return areaCode;
  }
  void setAreaCode(String arg) {
      areaCode = arg;
  }
  String getNumber() {
      return number;
  }
  void setNumber(String arg) {
      number = arg;
  }
}
14.优先考虑泛型
声明中具有一个或者多个类型参数(type parameter)的类或者接口,就是泛型(generic)类或者接口。泛型类和接口统称为泛型(generic type)。泛型从Java 5引入,提供了编译时类型安全检测机制。泛型的本质是参数化类型,通过一个参数来表示所操作的数据类型,并且可以限制这个参数的类型范围。泛型的好处就是编译期类型检测,避免类型转换。
// 比较三个值并返回最大值
public static <T extends Comparable<T>> T maximum(T x, T y, T z) {
  T max = x;
  // 假设x是初始最大值
  if ( y.compareTo( max ) > 0 ) {
    max = y; //y 更大
  }   if ( z.compareTo( max ) > 0 ) {
    max = z; // 现在 z 更大
  }   return max; // 返回最大对象
}
public static void main( String args[] ) {
  System.out.printf( "%d, %d 和 %d 中最大的数为 %d\n\n",  3, 4, 5, maximum( 3, 4, 5 ));
  System.out.printf( "%.1f, %.1f 和 %.1f 中最大的数为 %.1f\n\n",  6.6, 8.8, 7.7,  maximum( 6.6, 8.8, 7.7 ));
  System.out.printf( "%s, %s 和 %s 中最大的数为 %s\n","pear", "apple", "orange", maximum( "pear", "apple", "orange" ) );
}
质量如何保证
那么,对于老的代码或者新的代码,重构后,质量如何保证呢?
1.测试驱动开发
测试驱动开发(TDD)要求以测试作为开发过程的中心,要求在编写任何代码之前,
首先编写用于产码行为的测试,而编写的代码又要以使测试通过为目标。
TDD要求测试可以完全自动化地运行,并在对代码重构前后必须运行测试。
TDD的最终目标是整洁可用的代码(clean code that works)。大多数的开发者大部分时间无法得到整洁可用的代码。办法是分而治之。首先解决目标中的“可用”问题,然后再解决“代码的整洁”问题。这与体系结构驱动(architecture-driven)的开发相反。
采用TDD另一个好处就是让我们拥有一套伴随代码产生的详尽的自动化测试集。将来无论出于任何原因(需求、重构、性能改进)需要对代码进行维护时,在这套测试集的驱动下工作,我们代码将会一直是健壮的。
2.TDD的开发周期
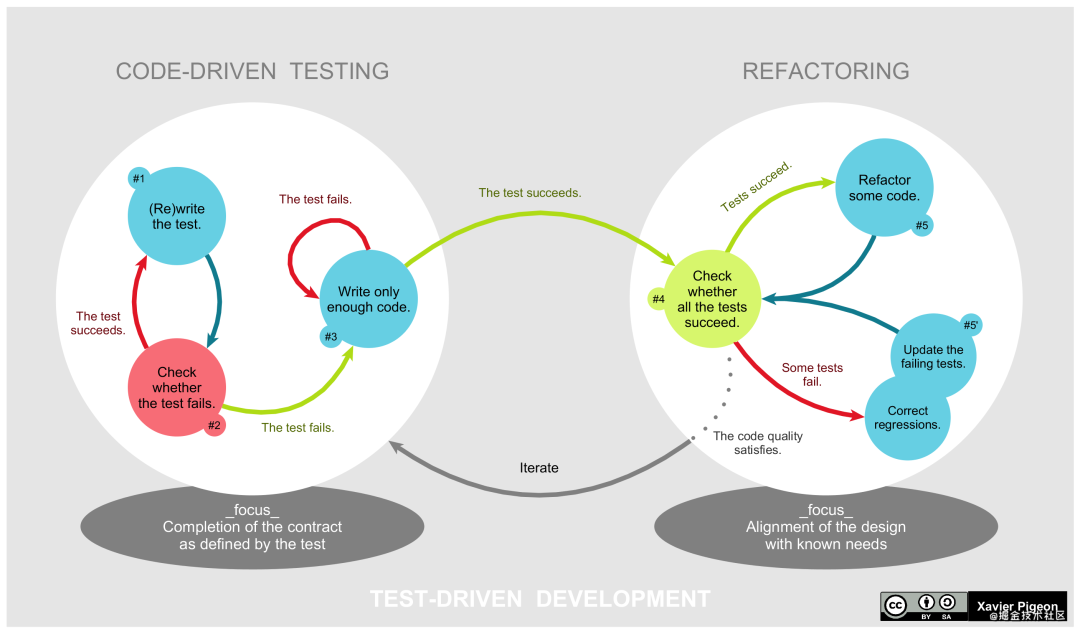
添加一个测试 -> 运行所有测试并检查测试结果 -> 编写代码以通过测试 -> 运行所有测试且全部通过 -> 重构代码,以消除重复设计,优化设计结构
3.两个基本原则
- 仅在测试失败时才编写代码并且只编写刚好使测试通过的代码
- 编写下一个测试之前消除现有的重复设计,优化设计结构
关注点分离是这两条规则隐含的另一个非常重要的原则。其表达的含义指在编码阶段先达到代码“可用”的目标,在重构阶段再追求“整洁”目标,每次只关注一件事!
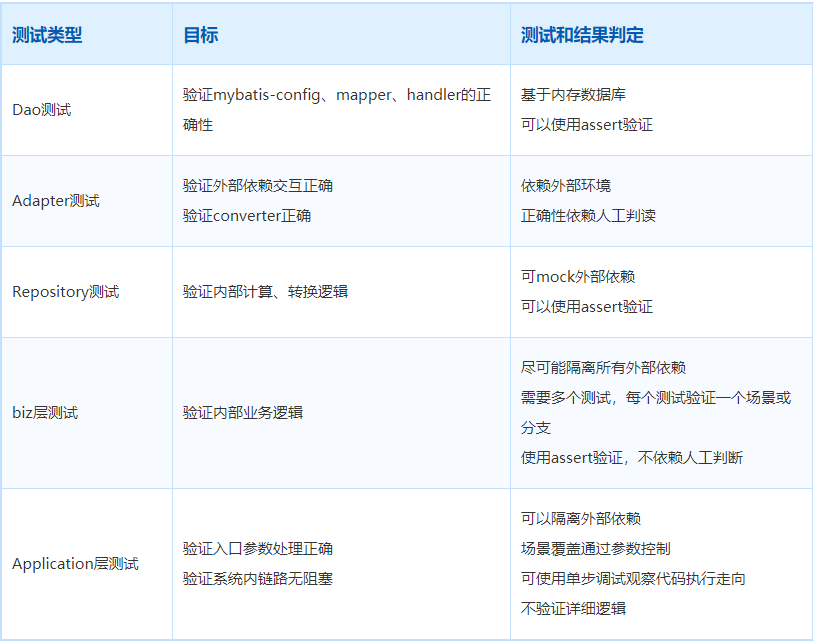
4.分层测试